Можно ли узнать с помощью ИНН другие данные человека или индивидуального предпринимателя? Где искать данные и когда это необходимо
Как найти человека по ИНН – популярный вопрос для сети. Но почему именно этот документ? Ответ прост – индивидуальный номер налогоплательщика присваивается каждому, а всем, кто находится в статусе индивидуального предпринимателя – ещё и дополнительный. Эти данные ведёт налоговая служба нашей страны. Но как же, зная только ИНН найти остальные данные? И зачем это нужно, если они по идее должны быть конфеденциальны?Подробнее ...
План реферата – основа научной работы. Именно на него преподаватель обращает пристальное внимание, поскольку это позволяет понять суть проекта и выявить правильную расстановку акцентов в теме. От грамотно составленного плана зависит содержание всего проекта и будущая оценка за него.
Подробнее ...
С тем, как по ФИО узнать прописку человека, нужно ознакомиться каждому – это поможет найти необходимого человека.Люди ищут друг друга по разным основаниям как личного, так и делового характера.
Зачем это может понадобиться
Ищут потерявшихся родственников и друзей, живущих в других регионах страны, связь с которыми потерялась после переезда, бывших одноклассников или сокурсников для организации встреч выпускников. Узнать адрес прописки в таких случаях нужно для отправки официального приглашения.Подробнее ...
Например на сайте очень длинный текст, а искать определённое предложение долго то как его быстро найти. Помню что как то делала с помощью каких то сочетаний клавиш.
Голосование за лучший ответ
Jhojitan Мудрец
(15002)
11 лет назад
ctrl плюс f
Игорь Максимов Просветленный
(39618)
11 лет назад
Правка – найти на этой странице, или Ctrl+F
The Demon Просветленный
(23591)
11 лет назад
В меню правка как правило есть кнопка поиск. В 2007 и 2010 офисе на вкладке главная есть кнопка поиск
Оксана Панюхина Ученик
(122)
5 лет назад
Очень просто, нажать кнопку F3 ( находится наверху клавиатуры) чуть выше цифр, выпадает окно, вставить нужное слово или фразу, поиск автоматически всё найдёт.
Бесплатный сервис поиска слов Адвего покажет онлайн все вхождения ключевых слов, стоп-слов и слов по заданному образцу. Поиск фраз и наборов символов на любом языке.
Как работает поиск слов и фраз в тексте
Скопируйте в первое поле проверяемый текст, а во втором поле укажите все слова и фразы по одной на строку, после чего нажмите кнопку “Найти”. Чтобы найти слова в документе или на странице сайта, скопируйте весь текст в поле для проверки.
По умолчанию система ищет только точные совпадения с указанной строкой (с учетом знаков препинания).
Например, по строке “номер” будет найдено слово “номер”, но не будут найдены слова “номерной” или “госномер”. Аналогично, при поиске по фразе “легкий завтрак” будет найдена только фраза “легкий завтрак”, но не будут найдены фразы “легким завтраком” или “легкий, завтрак”.
Чтобы задать поиск по маске, используйте символ звездочки * в начале, в конце или с обеих сторон каждого слова:
ра* — будут найдены все слова, начинающиеся на “ра”, в том числе слово “ра”: работа, разный, рад.
*ет — будут найдены все слова, заканчивающиеся на “ет”, в том числе слово “ет”: работает, полет, нет.
*ой* — будут найдены все слова, содержащие буквосочетание “ой” в любом месте: ойкнул, водопой, спокойствие.
Маску можно указать для одного или нескольких слов во фразе, правила будут применяться последовательно:
ра* *ет — будут найдены фразы только из двух рядом стоящих слов, первое из которых начинается на “ра”, а второе заканчивается на “ет”: рабочий совет, но не будут найдены фразы “свет комет” или “равная опора”.
Также можно найти все вхождения любой заданной последовательности символов в тексте — для этого необходимо добавить символ ! в начале и конце строки.
Например, по запросу !дом! будут найдены вхождения этого буквосочетания в словах “дом”, “домашний”, “одомашненный” и т. д., но выделены будут именно вхождения, а не слова целиком, в отличие от режима поиска по маске с символом *.
Чтобы выделить все вхождения конкретного слова или фразы в тексте, нажмите на строку с ними в таблице совпадений. Чтобы выделить все совпадения, нажмите на строку с общим количеством совпадений.
Проверять текст можно неограниченное количество раз — после его редактирования или изменения списка слов нажмите повторно кнопку “Найти” и система покажет результаты новой проверки.
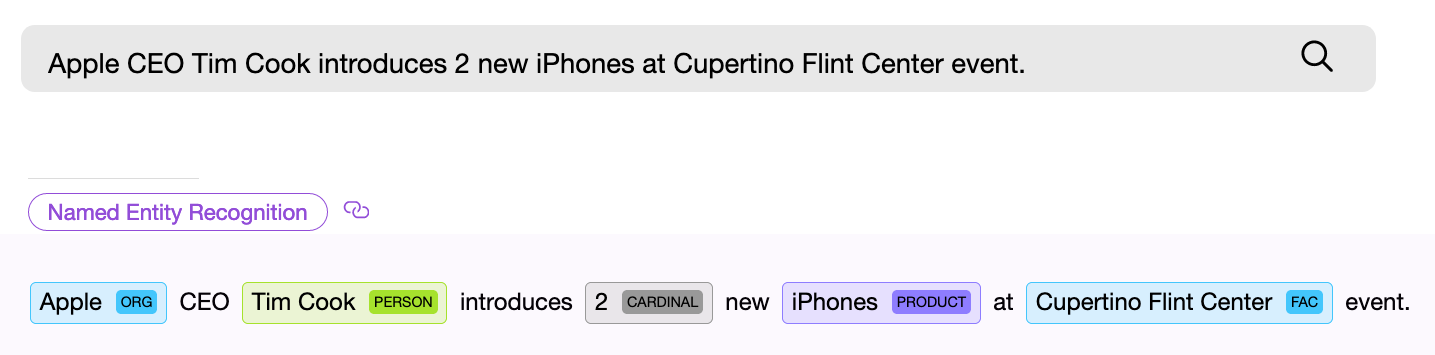
Найти объект или распознать понятие в тексте — с этого начинается решение большинства NLP задач. Если вы проектируете поисковую систему, создаете голосового помощника или классифицируете пользовательские запросы, прежде всего вы должны разобрать входной текст и попытаться найти в нем именованные сущности, которые могут быть универсальными, такими как даты, страны и города, или специфичными для конкретной модели. Обратите внимание, мы сейчас говорим лишь о тех видах задач, для которых заранее известно, что именно вы ищете или что может встретиться в тексте.
NER (named entity recognition) компонент, то есть программный компонент для поиска именованных сущностей, должен найти в тексте объект и по возможности получить из него какую-то информацию. Пример — “Дайте мне двадцать две маски”. Числовой NER компонент находит в приведенном тексте словосочетание “двадцать две” и извлекает из этих слов числовое нормализованное значение — “22”, теперь это значение можно использовать.
NER компоненты могут базироваться на нейронных сетях или работать на основе правил и каких-либо внутренних моделях. Универсальные NER компоненты часто используют второй способ.
Рассмотрим несколько готовых решений по поиску стандартных сущностей в тексте. В данной заметке мы остановимся на бесплатных или бесплатных с ограничениями библиотеках, а также расскажем о том, что сделано в проекте Apache NlpCraft в рамках данной проблематики. Представленный ниже список не является подробным и обстоятельным обзором, которых и так достаточное количество в сети, а скорее кратким описанием основных особенностей, плюсов и минусов использования этих библиотек.
Провайдеры NER компонентов
Apache OpenNlp
Apache OpenNlp предоставляет для английского языка достаточно стандартный набор NER компонентов, работающих с датами, временем, географией, организациями, числовыми процентами и персонами. Имеется небольшой набор и для других языков (испанский, голландский).
Поставка:
Java библиотека. Apache OpenNlp не поставляет модели вместе с основным проектом. Они доступны для скачивания отдельно.
Плюсы:
Apache лицензия. Модели протестированы на множестве внедрений.
Минусы:
Судя по всему, модели недаром вынесены из основного проекта. Складывается впечатление, что работа над ними или остановлена или идет в удручающе неторопливом темпе, так как новых моделей или изменений в существующих не видно уже довольно давно. Так как пользователи Apache OpenNlp могут создавать и тренировать свои собственные модели, возможно эта задача фактически полностью переложена на них.
Stanford Nlp
Stanford NLP — живой, постоянно развивающийся продукт отличного качества и широких возможностей. Для английского языка добавлена поддержка распознавания следующих сущностей: person, location, organization, misc, money, number, ordinal, percent, date, time, duration, set. Кроме того встроенный Regex NER компонент позволяет находить с высокой степенью точности такие сущности как: email, url, city, state_or_province, country, nationality, religion, (job) title, ideology, criminal_charge, cause_of_death, handle. Подробнее по ссылке. Заявлена поддержка ограниченного набора NER для немецкого, испанского и китайского языков. Качество распознавания можно попробовать с помощью онлайн демо.
Поставка:
Java библиотека. Модели можно загрузить из мавен вместе с проектом.
Я нигде не нашел перечня и детального описания NER компонентов для языков отличных от английского. По ссылкам 1, 2 — приведены примеры процесса тренировки собственных NER компонентов для разных языков. Проще говоря, возможность использовать другие языки заявлена, но придется повозиться.
Плюсы:
Ощущение от работы с проектом в целом и с готовыми моделями самое позитивное, проект живет и развивается, качество распознавания хорошее (”хорошее” — понятие условное, существуют метрики, характеризующие качество распознавания NER компонентов, но данный вопрос выходит за рамки статьи).
Минусы:
Помимо некоторого хаоса с документаций, они небольшие. Кому это важно, обратите внимание на лицензию. GNU General Public License отличается от Apache, так, например, вы не можете добавить продукт с данной лицензией в продукты, лицензируемые под Apache и т. д.
Google Language API
Google language API для английского языка поддерживает следующий список сущностей: person, location, organization, event, work_of_art, consumer_good, other, phone_number, address, date, number, price.
Платформа:
REST API, SaaS. Доступны готовые клиентские библиотеки над REST (Java, C#, Python, Go и т. д.).
Плюсы:
Большой набор NER компонентов, развитие и качество обеспечивается всем известным интернет гигантом.
Минусы:
Начиная с определенных объемов, использование платное.
Spacy
Данная библиотека предоставляет один из наиболее широких наборов поддерживаемых для распознавания сущностей, по ссылке список поддерживаемых.
Платформа:
Python.
К сожалению отсутствие личного опыта промышленного использования не позволяет мне добавить реальное описание плюсов и минусов данной библиотеки. К тому же подробный обзор питоновских NLP решений уже опубликован на habr.
Все вышеперечисленные библиотеки позволяют обучать собственные модели. Также все из них (кроме Apache OpenNlp) позволяют извлекать нормализованные значения из найденных сущностей, то есть, например, получить число “173“ из найденной в запросе числовой сущности “сто семьдесят три“.
Как мы видим вариантов решения задачи нахождения именованных сущностей представлено множество, направление их развития очевидно — расширение списка поддерживаемых языков и набора распознаваемых сущностей, улучшение качества распознавания.
Ниже описано, что привнес проект Apache NlpCraft в данную, уже широко проработанную область.
Дополнительные возможности предоставляемые NlpCraft
Собственные NER компоненты для новых сущностей, улучшенные варианты решения для некоторых уже существующих.
Интеграция NER компонентов всех вышеперечисленных библиотек в рамках использования продукта.
Поддержка “составных сущностей“, что дает пользователям простую возможность создания новых собственных компонентов на основе уже имеющихся.
Теперь обо всем этом чуть подробнее.
Собственные NER компоненты
Собственные NER компоненты Apache NlpCraft — это компоненты распознавания дат, чисел, географии, координат, сортировки и сопоставления разных сущностей. Часть из них уникальна, часть — лишь улучшенная реализация существующих решений (повышена точность распознавания, добавлены дополнительные поля значений и т. д.).
Интеграция существующих решений
Все перечисленные выше решения интегрированы для использования в Apache NlpCraft.
При работе с проектом пользователю достаточно подключить нужный модуль и указать в конфигурации какие именно NER компоненты должны быть задействованы при поиске сущностей конкретной модели.
Ниже приведен пример конфигурации, для которой при поиске в тексте используется четыре различных NER компонента от двух провайдеров:
Подробнее об использовании Apache NlpCraft написано здесь. Для использования Google Language API необходим действующий Google developer account.
Поддержка составных сущностей
Поддержка составных сущностей — самая интересная из вышеперечисленных возможностей, остановимся на ней немного подробнее.
Составная сущность — это сущность определенная на основе другой. Рассмотрим пример. Пусть вы разрабатываете NLP систему управления, основанную на интентах (см. Alexa, Google Dialogflow, Алиса, Apache NlpСraft и т. д.), и пусть ваша модель работает с географией, но только для США. Вы можете взять любой компонент для поиска географии, например ”nlpcraft:city”, и использовать его напрямую.
Далее, при срабатывании интента, вы в соответствующей ему функции (callback), должны проверить значение поля ”country”, и если оно не удовлетворяет требуемым условиям, завершить работу функции, предотвращая ложное срабатывание. Далее вы должны вернуться к матчингу и попытаться выбрать другую, более подходящую функцию.
Что не так в данном подходе:
Вы значительно усложняете работу с вызываемыми функциями, передавая управление из них в основной рабочий поток и обратно. Кроме того стоит учесть, что подобным функционалом передачи управления обладают далеко не все диалоговые системы.
Вы размазываете логику матчинга между интентом и кодом исполняемого метода.
Хорошо… Вы можете с нуля создать свой собственный NER компонент по поиску американских городов, но эта задача решается не за пять минут.
Попробуем иначе. Вы можете усложнить интент (в тех системах где это возможно) и искать города, дополнительно отфильтрованные по стране. Но, повторюсь, возможность сложной фильтрации по полям элементов предоставляют далеко не все системы, кроме того вы усложняете интенты, которые должны быть максимально понятными и простыми, особенно если их много в проекте.
Apache NlpCraft предлагает механизм определения собственных NER компонентов на основе уже существующих. Ниже приведен пример конфигурации (полный синтаксис DSL доступен по ссылке, пример создания элементов — тут):
В данном примере мы описываем новую именованную сущность “американский город“ — “custom:city:usa”, основанную на уже существующей “nlpcraft:city”, отфильтрованной по определенному критерию.
Теперь вы можете создавать интенты, опирающиеся на созданный новый элемент, а встреченные в тексте города за пределами США не вызовут нежелательного срабатывания ваших интентов.
iCloud – уникальный облачный сервис от корпорации “Эпл”. С его помощью можно сохранять различные данные, а также проводить их резервное копирование и восстановление. Ничего трудного в этом нет. Далее постараемся выяснить, как посмотреть фото в iCloud с iPhone. Что нужно для настройки отображения и сохранения снимков в этом облачном сервисе? И с какими трудностями чаще всего сталкиваются владельцы “яблочных” девайсов? Ответы на все перечисленные вопросы и не только обязательно пригодятся каждому. Особенно тем, кто планирует сменить “Андроид” на iOS.Подробнее ...
Дисперсия и среднее квадратичное отклонение числового ряда.
Дисперсия и Среднее квадратичное отклонение
числового ряда
Задача
Дисперсией ряда чисел называется среднее арифметическое
Оля и Гуля проводили подготовку к соревнованиям по стрельбе из лука. Спортсменки произвели по 7 серий выстрелов. Каждая серия состояла из 12 выстрелов. Получили следующие данные:Подробнее ...
Трение — вариант взаимодействия двух тел. Оно возникает при движении одного тела по поверхности другого. При этом тела действуют друг на друга с силой, которая называется силой трения. Сила трения имеет электромагнитную природу.Подробнее ...
Что это? Оборот продаж – это общая сумма проданных товаров или услуг. Не путайте с выручкой, из которой убираются расходы.
Как подсчитать? С помощью автоматизированных программ складского учета. Не забудьте потом проанализировать все расчеты, чтобы потом найти оптимальные способы увеличения оборота продаж.
Подробнее ...